


要点
動画や視覚的な学習が完璧な組み合わせだと思いがちです。しかし、チュートリアルを見て「完全に理解した!」と感じたのに、気づいたら何も覚えていなかったことはありませんか?情報がすっと消えてしまうのです。
これはよくある記憶保持の問題です。動画をただ受動的に見るだけだと、脳が戦略なしに情報を吸収しようとして認知過負荷に陥ります。情報をしっかり覚えるには、その受動的な視聴を積極的な学習に変え、構造化された視覚的なノート取りの方法が必要です。
動画をただ見るだけでは不十分な理由
視覚的学習者にとってはよくあるパラドックスです。説明動画をかけて手順通りに進め、「なるほど!」と思っても、一日経つと細かい部分がぼやけてしまいます。この「コンテンツ忘却症」は受動的な消費の典型的な症状です。脳に視る、聞く、処理するを同時にやらせてしまうのは、深く学ぶには非効率的です。
積極的に関与する方法がなければ、最も重要な部分、つまり視覚的文脈を失ってしまいます。
失われる視覚的文脈の問題
例えば、YouTubeのチュートリアルで新しいコーディング関数を学んでいるとします。講師がロジックを説明しながら正確な構文が画面に映し出されます。見てうなずきはするものの、実際には記憶にとどめていません。自分でコードを書く時には構造がはっきり思い出せないのです。
それは、コードの一部や図表、画面上のデモンストレーションそのものが記憶にしっかり結びついていなかったからです。テキストの書き起こしに頼るのはもっと悪く、画面上のコードは完全に失われてしまいます。詳しく知りたい方はこちらのYouTubeの動画書き起こしを学習に活用する方法をご覧ください。
昔ながらに動画を止めながらスクリーンショットを撮るのは使いにくく、集中力が途切れ、バラバラの画像だらけの雑多なフォルダができるだけです。動画学習を本当に活かすには、視覚情報を文脈付きで獲得するスマートな方法が必要です。
必要な視覚情報を効率的にキャプチャする方法
効果的な学習は正しい情報を捉えることから始まります。しかし視覚的学習者にとってはテキストだけでは不十分です。動画上の図やコード、段階的なデモが必要です。ただし動画を見ながら手動でノートを取るのは大変です。動画を何度も止めてスクリーンショットを撮り、ウィンドウ切り替えして貼り付ける作業は煩雑で学習の流れを乱します。
スムーズなキャプチャシステムを作る
はるかに良い方法は、視覚的証拠をその場でノートに直接埋め込むことです。これにより「散らばったスクショ」の問題を即座に解決し、すぐに文脈が得られます。ランダムなファイル名Screen Shot 2024-10-26 at 11.45.12 AM.pngのファイルではなく、書き込んだ内容のそばに視覚的なアンカーが付くのです。
ここで専用ツールの価値が発揮されます。例えば、HoverNotesはChromeの拡張機能で、動画を一緒に視聴しながらAIによるノートを生成し、MarkdownファイルとしてPC上に直接保存します。 書き起こしだけを解析するツールとは異なり、HoverNotesは動画をフレームごとに解析し、実際の画面上の図やコード、デモも含めてキャプチャします。
このアプローチによりノート取りは面倒な作業から、学習の一部として自然に溶け込みます。重要な視覚情報を正確に収集して学習資料を完全なものにできます。画面キャプチャの詳細はYouTube動画のスクリーンショット取得ガイドをご覧ください。
全画面キャプチャを超えて:必要な部分だけ切り抜く
動画の全画面が常に必要なわけではありません。特定の図表やコードのブロック、またはスライドの数式だけが欲しい場合があります。
そんな時は動画の特定領域だけを切り取るのがおすすめです。この方法でノートはシンプルかつ重要な視覚情報だけに集中できます。これはObsidianユーザーにとって大きなメリットです。ノートは.mdファイルとしてそのまま保存でき、埋め込み画像も自動的に表示されるので、あなたのナレッジベースが豊かで検索可能な視覚的資産になります。
マインドマップとキャンバスでアイデアをつなげる
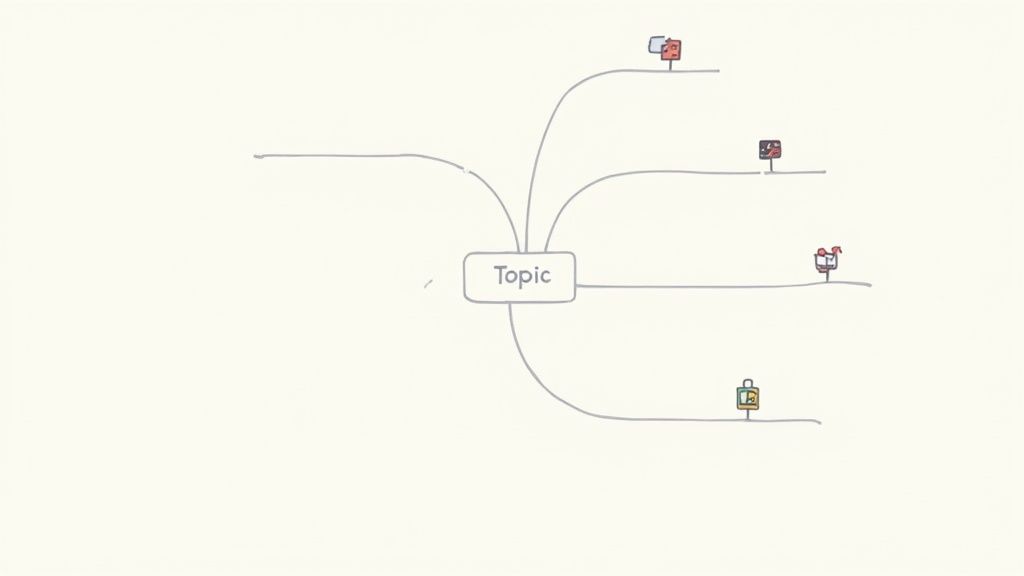
動画から重要な視覚情報を取り込むのは良いスタートですが、それだけでは不十分です。キャプチャしたスクリーンショットやノートがただのフォルダに溜まっているだけでは、漠然とした記憶よりましではありません。本当に学ぶのは、それらを整理して脳が全体像を把握できるようにした時です。
そこでマインドマップやデジタルキャンバスが効果的です。視覚的学習者にとっては、これらは私たちの思考が自然に結びつく空間的(線形ではない)な方法を模しているからです。テキストの壁に埋もれることなく、トピック全体を俯瞰できます。
視覚的知識の網を作る
Obsidianに備わるようなデジタルキャンバスを、あなた専用の無限大のホワイトボードだと考えてください。ここで強力な視覚的学習ガイドを作り上げます。
まずはシンプルに、動画のメイントピックを中央のノードとして作成します。そこから重要な概念へ枝分かれさせ、キャプチャしたスクリーンショットをそれぞれのアイデアの視覚的アンカーとして差し込みます。
この作業自体が、異なる情報のつながりを深く考えるきっかけとなります。例えば関数の構文のスクリーンショットから、そのロジックを説明する図へ直接線を引くこともできます。
静的ノートから動的学習ガイドへ
視覚ノートツールとキャンバスを組み合わせると、作業がスムーズにかみ合います。例えばHoverNotesなら、タイムスタンプ付き画像を埋め込んだMarkdownファイルをドラッグしてObsidianキャンバスに直接入れられます。
それぞれのノートは、すぐに動かせるカードになります。他のアイデアと繋げる準備もできています。
結果として、動的で生きた学習ガイドが完成します。マインドマップ内のある概念があいまいに感じたら、スクリーンショットをクリックしてください。どの画像もクリック可能なタイムスタンプ付きなので、ワンクリックで動画のその瞬間に戻って復習できます。複数の動画から情報をひとつにまとめる効果的な方法です。
ノート構造の詳しい解説は、効果的な学習ノートの取り方ガイドも参照してください。
受動的な視聴者から積極的な学習者へ
本当の学びは単なる受け取りではなく、積極的な関与です。動画をただ再生するだけでは、情報が流れ込んで少しだけ記憶に残るかもしれない、という期待に過ぎません。これはほとんど忘れることを保証する戦略です。
持続する知識を築くには、資料を能動的に処理しなければなりません。
そのために有効なのが、フェインマンテクニックの視覚的バリエーションです。動画の短い区間、1〜2分を見て一時停止。そして巻き戻さずにペンを取り、今学んだ概念を図として描いてみてください。フローチャートが描けますか?プロセス図は書けますか?
記憶から視覚を再現しようとするこのシンプルな行為が、脳に情報を処理させることを強制し、単なる受け身の視聴とは違う効果を生み出します。
見ることとやることを組み合わせる
この手法は認知科学の裏付けがあります。二重符号化理論と呼ばれ、視覚情報(スクリーンショットなど)と自分自身による言語・文章による説明(ノート作成)を組み合わせると記憶が強固になる、という説です。
動画の図をキャプチャし、それに自分の要約を書き添えると、同じアイデアに対して二本の異なる脳の経路ができます。この冗長性が、試験時の想起を格段にしやすくします。
ここで適切なツールの恩恵が大きいです。動画とノートを横並びで表示する気を散らさない動画モードなら、その場で要約・連携を促して「後でやろう」を排除します。
データもそれを裏付けます。視覚的な学習法による講義で学ぶ学生は、テキストだけの講義に比べて遅延テストで83%も優位な成績を出すことが示されています。秘訣は視覚情報と積極的な想起の組み合わせです。関連研究は視覚学習技術の研究まとめでご覧いただけます。
これを気軽に実践できるのが適切なツールです。例えばHoverNotesは、気が散らない動画モードで自分のノートを手書きしつつ、無料のスクリーンショット機能で重要な視覚資料を瞬時にキャプチャできます。ノートの整理方法についてはYouTube動画をノートに変える方法ガイドをご覧ください。
視覚的学習法の比較
視覚学習法はすべて同じではありません。受動的なテクニックは生産的に感じても、本当の学びは積極的に行動するところにあります。
結論は明快です:脳に視覚情報で何かをさせればさせるほど、記憶に残りやすくなります。見るだけでなく、真に理解することを目指しましょう。
持続可能な視覚的知識システムの構築
視覚的ノート取りは良い第一歩ですが、その後それらをどう扱うかが重要です。もしノートが忘れられたフォルダに放置されるだけなら、その価値は失われます。目標は個人的に所有できる検索可能な知識ベースを作り、学習時間を永続的な資産に変えることです。
これは、自分の努力が閉じ込められてしまうプロプライエタリなクラウドサービスから離れることに他なりません。だから多くの真剣な学習者はObsidianのようなローカルファーストツールに依存しています。ノートが自分のPCにあるMarkdownファイルなら、知識は将来にわたって守られます。ファイルは自分のものです。移動もバックアップも自在、grep検索もできます。それはただのMarkdownファイルだからです。
視覚資料ライブラリの整理
良いシステムは複雑である必要はありません。単純な方がむしろ効果的です。
自分に合った論理的なフォルダ構造から始めましょう。例えば、コース別や科目別に整理します。そこにタグ付けのレイヤーを追加して、#pythonや#calculusといったタグでノートを分類すれば、異なる動画講義の関連アイデアもすぐに呼び出せます。
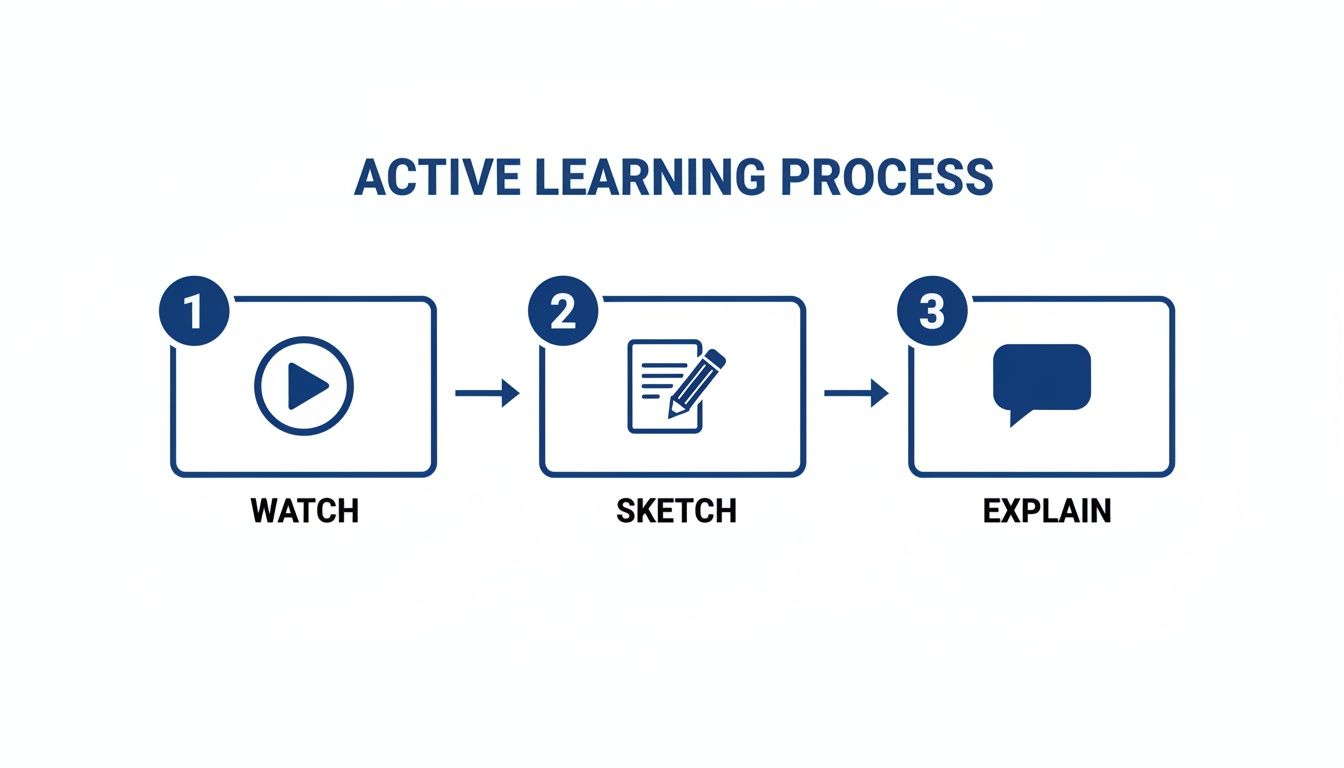
このシンプルな流れ―見る、スケッチする、説明する―こそが受動的な視聴を積極的な学びに変える鍵です。資料に直接触れることを強いられ、本当の理解が生まれるのです。
最後のステップは点をつなぐことです。ノートを孤立させるだけでなく、個別のコーディング関数のノートから、属しているプログラミングパラダイムのより広いノートにリンクをつけましょう。これが脳の仕組みを模した知識のウェブを築き、気づかなかった関連を見つけられます。
別のツールを使っても構いません。これらのノートはよくフォーマットされたMarkdownなので、Notionのようなアプリにそのままコピー&ペーストすれば、画像や書式もそのまま保持されます。
まだセットアップを迷っているなら、適切な個人知識管理ソフトの選び方を詳しく解説したガイドをどうぞ。
質問はありますか?動画学習について話しましょう。
視覚的学習者が動画授業を定着させる際に直面しがちな課題と、その実用的なアドバイスを紹介します。
「ノートを取るために動画を何度も止めたり巻き戻したりするのをどうやめる?」
動画の一時停止→再生→巻き戻しを繰り返すのは集中力を削ぎ、20分の講義が1時間もの苦行になることもあります。
簡単な対策は、画面を半分ずつに分けて動画を片側に、ノートをもう片側に表示する方法です。少しはマシになりますが、手動作業は残ります。
もっと良いのはAIに初期の重労働を任せることです。HoverNotesのようなツールは、あなたと一緒に動画を「見て」重要ポイントを抽出し、タイムスタンプ付きスクリーンショットも自動で取得します。これでリアルタイムで教材の理解に集中でき、あとからAI作成のアウトラインに自分の意見を書き足せます。学習の流れを崩さずに済みます。
「デジタルと紙のマインドマップ、視覚学習にはどちらが良い?」
目的によります。
最初のブレインストーミングにはホワイトボードや紙が最適です。速く、触覚的で、ソフトの操作で煩わされずアイデアを出せます。
しかし長期学習にはデジタルマインドマップが革命的です。例えばObsidianのキャンバスなら、クリックで動画のその瞬間に戻れるスクリーンショットを埋め込めます。概念間のリンクやドラッグ&ドロップでの再配置も簡単です。動画学習においては、視覚ノートが元資料に直結したままであるデジタル方式の方がはるかに有力です。
「視覚ノートをどう復習するのがベスト?」
ノートを見返すだけでは不十分です。情報を定着させる最良の方法は、能動的想起と間隔反復の組み合わせです。
マインドマップを漫然と読み返すのではなく、文字部分を隠し、保存しておいた図を見て、記憶から声に出して説明しましょう。あたかも誰かに教えているように。
タイムスタンプ付きのスクリーンショットは強力な自己テストツールです。ノート部分を隠し、画像を見て説明し、それからその画像をクリックして動画に戻り、合っていたか確認します。この復習を例えば1日、3日、1週間後に繰り返すことで、記憶想起が強化され、長期記憶が築かれます。
Obsidianユーザーなら、動画ノートをクリーンなMarkdownファイルとしてバウルトに直接保存する機能で、視覚ナレッジベースの構築がほぼ自動化されます。ノートはNotionにも綺麗にコピー可能です。HoverNotesは無料で試せ、登録だけでAIクレジットが20分分もらえます。クレジットカード不要です。詳しくはこちらからどうぞ。
学習研究が支持していること
有用なノートとは、単に文字情報を蓄えるものではなく、学習内容に対して何らかの働きかけを促すものです。米国教育科学研究所は、学習を時間を空けて分散させること、図表と口頭説明を組み合わせること、能動的な想起を用いること、深い説明を求める問いを立てることを推奨しています(practice guide)。教育動画研究に関する査読済みレビューでも、重要な情報を明示すること、授業を扱いやすい単位に分割すること、学習者に操作の主導権を持たせること、能動学習を促すプロンプトを加えることが重視されています(review)。ここに当てはめるなら、概念の切れ目で一時停止し、必要な視覚的根拠だけを記録し、自分の言葉で問いを書き、あとで元の動画を再生する前にその問いに答える、ということです。こうした実践にはエビデンスがありますが、特定のアプリやワークフローについて、誰にでも当てはまる保持率の割合が存在するわけではありません。



